算力霸权 英伟达如何掐住人工智能基础软件开发的命脉
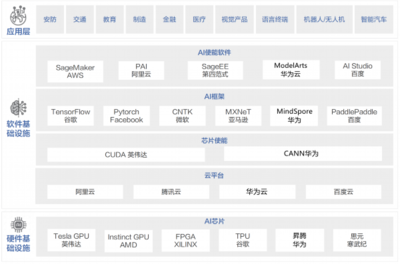
放眼当下,英伟达已然掌控了人工智能基础设施的几乎所有命脉,如同掐住人工智能基础软件开发的咽喉。从训练大模型所依赖的GPU芯片,到串联成千上万块芯片的NVLink互连,再到支撑开发者调用算力的CUDA编程框架,英伟达构建起了一条几乎无缝隙的软硬件一体化护城河。全球主流AI框架——PyTorch、TensorFlow、JAX——底层无不优先适配CUDA,数以百万计的AI工程师的代码习惯、调优经验与工具链,都牢牢绑定在这一生态之上。
这种控制力的核心,不在于单一硬件的性能领先,而在于“硬件+软件+生态”的飞轮效应。CUDA自2006年问世以来,积累了庞大的库、SDK与社区资源,新入局者即便造出纸面参数更优的芯片,也难在短时间内复制这套开发者生态。于是,基础软件开发的节奏被迫跟着英伟达的架构演进而调整:新模型要优化,首先想的是如何压榨H100、B200的算力;新算子要落地,首先查的是CUDA是否有现成实现。基础软件的创新空间,在无形中被框定在英伟达设定的坐标系里。
更值得警惕的是供应链层面的“单点依赖”。高端GPU的产能、出口管制政策、云端算力租赁价格,任何一环波动都会迅速传导至基础软件研发端——创业公司排不到卡,就只能缩减实验规模;研究机构拿不到新架构,就只能滞后适配。基础软件本应是百花齐放的创新前沿,却在算力入口处被层层收窄。
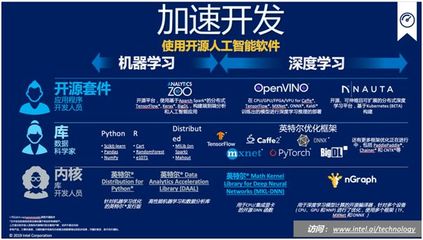
裂缝正在出现。AMD的ROCm、英特尔的oneAPI、开源指令集RISC-V以及各大云厂商的自研芯片,都在试图撕开生态缺口;PyTorch 2.x对多后端的支持、Triton等跨平台编译工具的兴起,也让“去CUDA化”有了技术抓手。但短期内,英伟达的生态惯性仍然强大。对于人工智能基础软件开发者而言,清醒认识这一格局,既要在现有生态中高效求生,也要积极为多后端、可移植的技术路线投票,唯此才能在算力霸权的夹缝中,为软件创新保留真正的自主空间。
如若转载,请注明出处:http://www.inylhki.com/product/8.html
更新时间:2026-11-01 16:19:14