基于深度学习的人工智能技术架构体系 从基础软件到应用全景解析
人工智能(AI)的浪潮正以前所未有的速度重塑各行各业,而深度学习作为其核心驱动力,背后依赖的是一套复杂且精密的技術架构体系。本文将从基础软件开发视角切入,系统梳理基于深度学习的人工智能技术架构层次,涵盖硬件、软件框架、模型算法及上层应用,力求为读者呈现一份完整的“干货”地图。
一、总体架构概览:四层体系
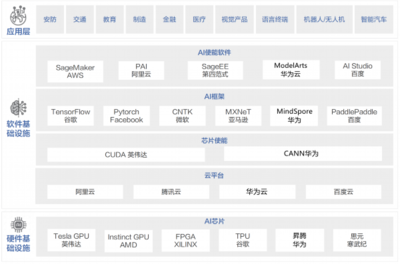
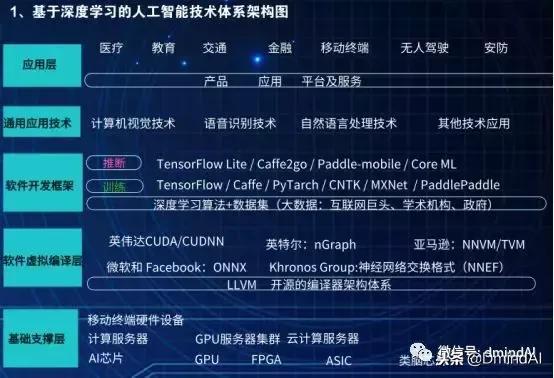
基于深度学习的人工智能技术架构可抽象为四层:硬件层、基础软件层、算法模型层和应用层。
- 硬件层提供算力基础,包括GPU、TPU、NPU等专用芯片及异构计算集群。
- 基础软件层是连接硬件与算法的桥梁,包含深度学习框架、编译器、驱动、运行时库、分布式训练系统等。
- 算法模型层涵盖各类深度神经网络结构(CNN、RNN、Transformer等)及训练推理算法。
- 应用层则面向具体场景,如语音识别、计算机视觉、自然语言处理等。
本文重点探讨基础软件层,因其是AI基础软件开发的核心战场,也是支撑上层创新的基石。
二、硬件层:算力基石与异构计算
深度学习的规模化训练依赖高性能计算资源。当前主流硬件包括:
- GPU:凭借并行计算能力成为深度学习训练首选,NVIDIA CUDA生态占据主导,AMD ROCm、AMD Instinct等也在追赶。
- TPU/ASIC:Google TPU为TensorFlow定制,国内寒武纪、华为昇腾等也推出ASIC加速卡,针对特定算子优化,能效比高。
- NPU:手机等端侧AI芯片,如苹果Neural Engine、高通Hexagon。
- FPGA:可重构特性适合特定推理场景。
硬件层之上需有统一的驱动与运行时接口,以屏蔽异构硬件差异,这为统一编程模型和编译器提出了需求。
三、基础软件层:AI基础软件的全景图
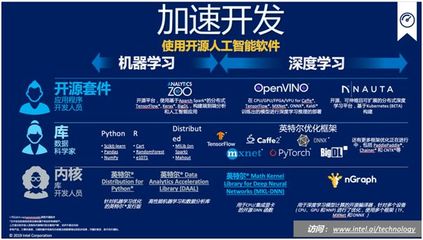
基础软件层是AI技术架构的“操作系统”,主要包括以下组件:
3.1 深度学习框架
框架是开发者构建模型的入口,主流框架有:
- TensorFlow:Google出品,生态完善,支持静态图和动态图(Eager Execution),部署工具链齐全。
- PyTorch:Facebook主导,动态图灵活,研究社区活跃,现已成为学术界首选。
- MindSpore:华为开源,支持端边云全场景,自动并行。
- PaddlePaddle:百度开源,中文文档友好,产业实践丰富。
- JAX:Google Research推出,函数式编程,自动微分+编译加速(XLA),在高性能计算研究中流行。
框架需提供自动微分、张量计算、模型保存与加载、分布式训练等核心功能。
3.2 编译器与运行时
为了提升模型执行效率,编译技术被引入深度学习。典型工具有:
- XLA(Accelerated Linear Algebra):TensorFlow/JAX的编译器,将计算图编译为硬件专用代码。
- TVM:开源深度学习编译器栈,支持多种硬件后端,可进行算子优化和自动调度。
- MLIR:多级中间表示,为ML硬件和软件构建可重用编译器基础设施。
- TensorRT:NVIDIA推理优化器,针对GPU推理进行层融合、精度校准等优化。
- ONNX Runtime:跨框架推理引擎,支持ONNX模型格式,可在多种硬件上高效运行。
编译器需解决图优化(算子融合、常量折叠)、内存规划、自动并行、量化等关键问题。
3.3 驱动与运行时库
底层软件如CUDA、cuDNN(NVIDIA)、ROCm(AMD)、OneAPI(Intel)提供GPU编程接口和深度神经网络加速库。国产AI芯片也配套类似驱动和算子库(如华为CANN)。
3.4 分布式训练系统
大模型训练需分布式系统支撑,关键技术包括:
- 数据并行:每个设备持有完整模型副本,处理不同数据分片,梯度聚合(AllReduce)。
- 模型并行:将模型切分到不同设备,如流水线并行(Pipeline Parallelism)、张量并行(Tensor Parallelism)。
- 混合并行:结合数据与模型并行,如Megatron-LM、DeepSpeed。
- 通信优化:NCCL(NVIDIA Collective Communications Library)等集合通信库。
- 调度与容错:Kubernetes+Volcano等调度框架。
代表系统有Horovod、PyTorch Distributed、DeepSpeed、Megatron-LM等。
3.5 模型部署与推理引擎
训练好的模型需高效部署到云端或端侧:
- 推理引擎:TensorRT、ONNX Runtime、OpenVINO(Intel)、TFLite(Google)、NCNN(腾讯)、MNN(阿里)、Paddle Lite等,针对推理优化,支持量化、剪枝、算子融合。
- 服务化框架:Triton Inference Server、TensorFlow Serving、TorchServe,支持多模型、动态批处理、A/B测试。
- 边缘计算:模型压缩(量化、剪枝、知识蒸馏)+专用推理框架,实现端侧低延迟推理。
3.6 自动化机器学习(AutoML)
降低AI应用门槛,包括神经架构搜索(NAS)、超参数优化、自动特征工程等。工具如Google AutoML、NNI(微软)、AutoKeras等。
四、算法模型层:深度学习的核心引擎
算法层涵盖网络结构、训练策略与优化方法:
- 基础网络:CNN(ResNet、EfficientNet)、RNN/LSTM、Transformer(BERT、GPT)、GAN、扩散模型(Diffusion)。
- 训练技巧:批归一化、Dropout、残差连接、注意力机制、学习率调度、正则化。
- 优化器:SGD、Adam、LAMB等。
- 自监督学习:SimCLR、MoCo、MAE等,减少标注依赖。
- 强化学习:DQN、PPO、SAC等,与深度学习结合形成深度强化学习。
算法层的进展直接驱动基础软件需求,如Transformer促成混合精度训练、模型并行等技术发展。
五、应用层:场景落地与生态
基础软件支撑上层应用研发:
- 计算机视觉:图像分类、目标检测、分割、人脸识别、OCR。
- 自然语言处理:机器翻译、文本分类、问答系统、大语言模型(LLM)应用。
- 语音技术:语音识别、语音合成、声纹识别。
- 推荐系统:点击率预估、召回排序。
- 科学计算:AlphaFold2蛋白质结构预测、气象预报等。
这些应用反向驱动基础软件优化,如大模型催生万亿参数分布式训练框架。
六、趋势与展望
- 软硬协同设计:针对AI芯片定制编译器与算子库,提升计算效率。
- 大模型时代的基础软件:超大规模分布式训练、混合并行、显存优化(ZeRO)、通信压缩成为重点。
- MLOps与全流程管理:实验跟踪、模型版本管理、持续集成/持续部署(CI/CD)工具链。
- 隐私计算与联邦学习:基础软件集成加密计算能力,保障数据安全。
- 国产化与自主可控:国内AI基础软件(框架、编译器、芯片)生态加速构建。
七、
基于深度学习的人工智能技术架构是一个多层协同的复杂系统,其中基础软件层承上启下,是AI技术创新的关键环节。从PyTorch的动态图到TensorRT的推理优化,从XLA编译器到DeepSpeed分布式训练,每一项基础软件的突破都拓展了AI的能力边界。掌握这一架构体系,对于AI开发者而言,既是理解技术全貌的根基,也是进行系统级创新的契机。希望本文能为你提供一份清晰的“你想要的都有”的地图,助力在AI浪潮中扎实前行。
如若转载,请注明出处:http://www.inylhki.com/product/4.html
更新时间:2026-11-01 05:27:21