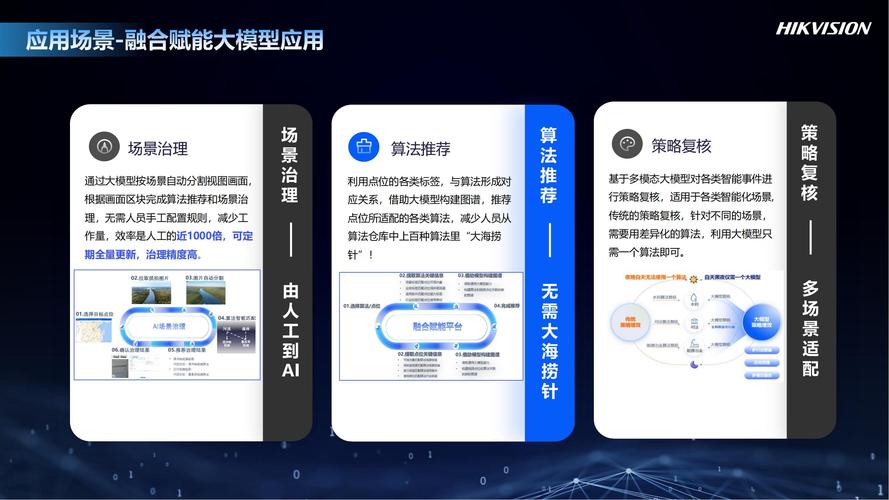
第九章 大模型与人工智能基础软件开发 9.1 大模型概述
9.1 大模型概述
1. 引言
随着人工智能技术的迅猛发展,大规模预训练模型(Large Pre-trained Models,简称大模型)已成为人工智能基础软件开发的基石。从自然语言处理到计算机视觉,从语音识别到多模态融合,大模型正在推动人工智能应用进入新的时代。本章将系统介绍大模型的概念、发展历程、关键技术、典型应用及其对基础软件开发的影响。
2. 大模型的定义与特征
2.1 定义
大模型通常指参数规模超过数十亿甚至数万亿的深度神经网络模型,通过在海量数据上进行预训练,学习到丰富的特征表示和知识,并可通过微调或提示等方式适配下游任务。
2.2 主要特征
- 规模巨大:参数数量级从亿级到万亿级,训练数据量达TB甚至PB级别。
- 预训练与微调范式:先在大规模无标注数据上预训练,再针对特定任务微调或直接零样本/少样本推理。
- 通用性强:一个模型可处理多种任务,减少针对每个任务独立开发模型的需求。
- 涌现能力:当模型规模达到一定程度时,表现出小模型不具备的能力,如复杂推理、上下文学习。
- 多模态能力:部分大模型可同时处理文本、图像、音频等多种模态信息。
3. 大模型的发展历程
- 2018年:BERT和GPT-1的发布标志着预训练语言模型时代的开启。
- 2019年:GPT-2展示了大模型在零样本任务上的潜力。
- 2020年:GPT-3以1750亿参数引发广泛关注,展示了上下文学习能力。
- 2021年:多模态模型CLIP、DALL·E出现,大模型开始跨模态发展。
- 2022年:ChatGPT基于GPT-3.5,通过RLHF技术实现对话能力突破,推动大模型普及。
- 2023年:GPT-4、LLaMA系列、文心一言等模型相继发布,开源与闭源生态并行发展。
- 2024年至今:模型规模持续扩大,多模态、长上下文、高效推理成为研究热点,行业应用加速落地。
4. 大模型的关键技术
4.1 模型架构
主要基于Transformer架构,利用自注意力机制捕捉长距离依赖。典型结构包括Encoder-only(如BERT)、Decoder-only(如GPT系列)、Encoder-Decoder(如T5)。
4.2 预训练技术
- 自监督学习:利用掩码语言建模、下一词预测等任务从无标注数据中学习。
- 分布式训练:数据并行、模型并行、流水线并行等技术支撑超大规模训练。
- 混合精度训练:使用FP16/FP32混合精度加速训练并减少显存占用。
4.3 微调与适配
- 全参数微调:更新所有参数,计算资源需求大。
- 参数高效微调:如LoRA、Adapter、Prefix-Tuning,仅训练少量参数。
- 提示工程与上下文学习:通过设计提示词激发模型能力,无需参数更新。
- 基于人类反馈的强化学习(RLHF):对齐模型输出与人类偏好。
4.4 模型压缩与推理优化
- 量化:将模型权重从FP32转为INT8等低精度,减少存储和计算开销。
- 剪枝:移除冗余参数或结构。
- 知识蒸馏:用大模型指导小模型训练。
- 推理引擎优化:如TensorRT、ONNX Runtime、vLLM等。
5. 大模型的典型应用
- 自然语言处理:文本生成、翻译、摘要、问答、情感分析。
- 计算机视觉:图像分类、目标检测、图像生成(如Diffusion模型)。
- 多模态:图文匹配、视觉问答、视频理解。
- 语音处理:语音识别、语音合成。
- 代码生成:GitHub Copilot等辅助编程工具。
- 科学研究:蛋白质结构预测、药物发现。
6. 大模型对人工智能基础软件开发的影响
6.1 开发范式的转变
- 从“针对任务开发模型”转向“预训练+微调/提示”的范式。
- 基础软件栈需支持大规模分布式训练和高效推理。
6.2 基础软件栈的演进
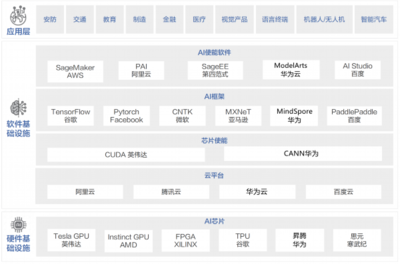
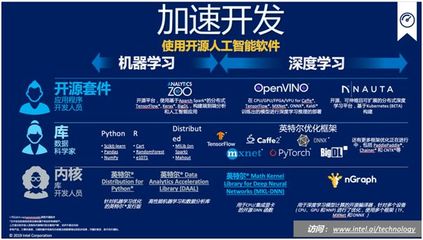
- 深度学习框架:PyTorch、TensorFlow、MindSpore、PaddlePaddle等不断增强对大模型的支持。
- 分布式训练框架:Megatron-LM、DeepSpeed、Horovod等提供并行训练能力。
- 模型库与工具链:Hugging Face Transformers、ModelScope等汇集大量预训练模型,简化开发。
- 推理与部署:Triton Inference Server、TensorRT、vLLM等支持高性能推理。
6.3 工程实践挑战
- 计算资源需求:训练大模型需要大规模GPU集群,成本高昂。
- 数据管理:海量数据的采集、清洗、标注与隐私保护。
- 模型评估与监控:需要系统化的评估方法和持续监控机制。
- 能效与绿色AI:降低训练和推理的能耗,推动可持续发展。
7. 挑战与未来趋势
- 挑战:计算资源瓶颈、数据偏见与伦理问题、模型可解释性、安全与隐私、环境影响。
- 趋势:
- 更大规模与更高效架构(如MoE混合专家模型)。
- 多模态统一模型。
- 边缘端轻量化大模型。
- 开源生态与协作。
- 标准化与监管框架。
8. 小结
大模型作为人工智能基础软件开发的核心,正深刻改变技术栈和开发模式。理解大模型的基本概念、关键技术和工程实践,对于构建新一代智能应用至关重要。后续章节将深入探讨大模型的训练、微调、部署及具体应用案例。
思考题
- 大模型与传统深度学习模型的主要区别是什么?
- 简述大模型预训练和微调的基本流程。
- 列举三种以上大模型开发中常用的基础软件工具。
- 讨论大模型对计算资源的需求带来的挑战及可能的解决方案。
如若转载,请注明出处:http://www.inylhki.com/product/11.html
更新时间:2026-11-01 14:00:52